2BC 第8章
8. 確率分布と統計
確率分布と統計の全体像
Point 2BC 8.1.1 確率分布と統計の全体像
確率分布と統計は,大きく分けて3テーマ!
① 確率分布
\(\cdots\) 「色々な確率分布の期待値・分散・標準偏差等が求められるか」,
「確率変数を変換できるか」が頻出テーマ!数Iのデータの分析と同じ感じ。 ② 二項分布と正規分布
\(\cdots\) 確率分布の中でも,反復試行の確率分布は二項分布と呼ばれる。
また,その反復試行の試行回数が大きくなると,正規分布と呼ばれるものに近づく。
そしていろいろな正規分布を,キホンの形に変える「標準化」と,標準化することで
利用できるようになる「正規分布表」を用いた確率の計算などが頻出テーマ! ③ 統計的な推測
\(\cdots\) 「母集団と標本」,「推定」,「(仮説)検定」がメインテーマ!
膨大なデータ(「母集団」)を全て調べるのは大変なので,一部分だけ抽出した「標本」
を調べ,元の母集団がどんな平均値や分散をもっていたのか「推定」する。
また検定では,ある主張が正しいかどうか統計的に判定する。 ※二項分布は通常①に分類されるが,わかりやすさを重視して②に分類した。
\(\cdots\) 「色々な確率分布の期待値・分散・標準偏差等が求められるか」,
「確率変数を変換できるか」が頻出テーマ!数Iのデータの分析と同じ感じ。 ② 二項分布と正規分布
\(\cdots\) 確率分布の中でも,反復試行の確率分布は二項分布と呼ばれる。
また,その反復試行の試行回数が大きくなると,正規分布と呼ばれるものに近づく。
そしていろいろな正規分布を,キホンの形に変える「標準化」と,標準化することで
利用できるようになる「正規分布表」を用いた確率の計算などが頻出テーマ! ③ 統計的な推測
\(\cdots\) 「母集団と標本」,「推定」,「(仮説)検定」がメインテーマ!
膨大なデータ(「母集団」)を全て調べるのは大変なので,一部分だけ抽出した「標本」
を調べ,元の母集団がどんな平均値や分散をもっていたのか「推定」する。
また検定では,ある主張が正しいかどうか統計的に判定する。 ※二項分布は通常①に分類されるが,わかりやすさを重視して②に分類した。
目次をしっかりと把握して,体系的な理解を大切に
確率分布
Point 2BC 8.2.1 確率変数の期待値・分散・標準偏差
・確率変数 \( X \) の期待値(平均)\( E(X) \) ・確率変数 \( X \) の分散 \( V(X) \) \( X \) の期待値\( E(X) \)を \( m \) とすると, \[
\begin{aligned}
①\ \ V(X) &= \class{mathkuu}{\underline{(x_1 - m)^2 p_1 + \cdots + (x_n - m)^2 p_n}}\\
&= \class{mathkuu}{\underline{\sum\limits_{k=1}^n (x_k - m)^2 p_k}}\ \left( =E((X-m)^2)\right)
\end{aligned}
\] \[
② V(X) = \class{mathkuu}{\underline{E(X^2) - \{E(X)\}^2}}
\] ・確率変数 \( X \) の標準偏差 \( \sigma(X) \)
\[
\sigma(X) = \class{mathkuu}{\underline{\sqrt{V(X)}}}
\]
\[
\begin{aligned}
E(X) &= \class{mathkuu}{\underline{x_1 p_1 + x_2 p_2 + \cdots + x_n p_n}}\\
&= \class{mathkuu}{\underline{\sum\limits_{k=1}^n x_k p_k}}
\end{aligned}
\]
\(
\begin{array}{|c|c|c|c|c|c|}
\hline
X & x_1 & x_2 & \cdots & x_n & 計 \\
\hline
X - m & x_1 - m & x_2 - m & \cdots & x_n - m & \\
\hline
(X - m)^2 & (x_1 - m)^2 & (x_2 - m)^2 & \cdots & (x_n - m)^2 & \\
\hline
P & p_1 & p_2 & \cdots & p_n & 1 \\
\hline
\end{array}
\)
統計確率の分野では,期待値=平均と認識せよ!
→そうすればあらゆる公式が数Ⅰのデータの分析と対応する! 例:上の分散公式について
①は「偏差の2乗の期待値」,②は「(2乗の期待値)-(期待値の2乗)」
であるから,期待値をすべて平均と言い換えればデータの分析の分散公式と全く同じ!
これが分かれば新しく覚えることはない! また,データの分析同様,分散公式①で求める際に確率分布の\(X\)と\(P\)の段の間に\((X-m)^2\)の段を用意したり,分散公式②で求める際に\(X\)と\(P\)の段の間に\(X^2\)の段を用意すると間違えずに計算しやすい。
→そうすればあらゆる公式が数Ⅰのデータの分析と対応する! 例:上の分散公式について
①は「偏差の2乗の期待値」,②は「(2乗の期待値)-(期待値の2乗)」
であるから,期待値をすべて平均と言い換えればデータの分析の分散公式と全く同じ!
これが分かれば新しく覚えることはない! また,データの分析同様,分散公式①で求める際に確率分布の\(X\)と\(P\)の段の間に\((X-m)^2\)の段を用意したり,分散公式②で求める際に\(X\)と\(P\)の段の間に\(X^2\)の段を用意すると間違えずに計算しやすい。
Point 2BC 8.2.2 確率変数の一次式の変換 まとめ
確率変数 \( X \) と定数 \( a \), \( b \) に対して,新たな確率変数\( Y = aX + b \) とすると,
\[
\begin{aligned}
\text{期待値} \ :\ E(Y) = &E(aX+b)= \class{mathkuu}{\underline{aE(X) + b}} \\
\text{分散} \ :\ V(Y) = &V(aX+b)= \class{mathkuu}{\underline{a^2 V(X)}} \\
\text{標準偏差} \ :\ \sigma(Y) = &\sigma(aX+b)= \class{mathkuu}{\underline{|a| \sigma(X)}}
\end{aligned}
\]
※これも数学ⅠA「データの分析」の変量の変換まとめと同じ。テストの全員の点数を\(a\)倍して\(b\)足せば平均もそうなるし,全員の点数を\(a\)倍すれば,分散は2乗で効いてくる。(定義に代入すれば明らか)
ただ,全員の点数に何点か足しても散らばり度合いには影響はしないから,定数\(b\)を足したところで分散は変わらないことも直感と一致する。
ただ,全員の点数に何点か足しても散らばり度合いには影響はしないから,定数\(b\)を足したところで分散は変わらないことも直感と一致する。
Point 2BC 8.2.3 独立について まとめ
確率変数の独立:
2つの確率変数 \( X, Y \) とそれらがとり得る任意の値 \( x_i, y_j \) について,次の式が成り立つとき,2つの確率変数\( X, Y \) は独立であるという。 \[ P(X = x_i, \, Y = y_j) = \class{mathkuu}{\underline{P(X = x_i) P(Y = y_j)}} \] 要するに,2つの確率変数 \( X, Y \) があるとき,それぞれの確率変数からどんな値をとってきたとしても,
(3つの確率変数についても同様。)
2つの確率変数 \( X, Y \) とそれらがとり得る任意の値 \( x_i, y_j \) について,次の式が成り立つとき,2つの確率変数\( X, Y \) は独立であるという。 \[ P(X = x_i, \, Y = y_j) = \class{mathkuu}{\underline{P(X = x_i) P(Y = y_j)}} \] 要するに,2つの確率変数 \( X, Y \) があるとき,それぞれの確率変数からどんな値をとってきたとしても,
(\(x_3\)が起きてかつ\(y_7\)が起きる確率)
\(=\)(\(x_3\)が起きる確率)\(\times\)(\(y_7\)が起きる確率)
のような式が成り立つということ。\(=\)(\(x_3\)が起きる確率)\(\times\)(\(y_7\)が起きる確率)
(3つの確率変数についても同様。)
事象\(A\)と事象\(B\)が独立 \(\Longleftrightarrow\) \(P(A \cap B) = P(A) \times P(B)\)
事象\(A\)と事象\(B\)が独立でない \(\Longleftrightarrow\) \(P(A \cap B) \mathrel{\bcancel{\mkern-8mu=\mkern-8mu}} P(A) \times P(B)\)
・「2つの試行 \( S, T \) が独立である」:その結果である \( S \) の事象 \( A \),\( T \) の事象 \( B \) について,一方で事象 \( A \) が起こり,もう一方で事象 \( B \) が起こる確率は \( P(A) \times P(B) \) で表される。つまり「試行が」独立であるとき,その試行によって生じる様々な事象は全て独立であるという事。
個人的に一番わかりやすいのは,下のようにカルノー図を描いて視覚的に捉える方法。事象\(A\)と事象\(B\)が独立でない \(\Longleftrightarrow\) \(P(A \cap B) \mathrel{\bcancel{\mkern-8mu=\mkern-8mu}} P(A) \times P(B)\)
カルノー図を書いたときに区切りがズレなければ独立,ズレたら独立でない。

Point 2BC 8.2.4 確率変数の和(差)や積の分解
確率変数 \( X \), \( Y \) と定数 \( a \), \( b \) に対して,
\[ \begin{aligned} E(X + Y) &= \class{mathkuu}{\underline{E(X) + E(Y)}}\\ E(aX + bY) &= \class{mathkuu}{\underline{aE(X) + bE(Y)}} \end{aligned} \] 確率変数 \( X \) と \( Y \) が独立であるならば
\[ \begin{aligned} \text{期待値} \quad E(XY) &= \class{mathkuu}{\underline{E(X)E(Y)}} \\ \text{分散} \quad V(X + Y) &= \class{mathkuu}{\underline{V(X) + V(Y)}} \end{aligned} \] 確率変数 \( X \) と \( Y \) が独立でない(従属)ならば
\[ \begin{aligned} \text{期待値} \quad E(XY) &\class{mathkuu}{\underline{\mathrel{\bcancel{\mkern-8mu=\mkern-8mu}}}} E(X)E(Y) \\ \text{分散} \quad V(X + Y) &\class{mathkuu}{\underline{\mathrel{\bcancel{\mkern-8mu=\mkern-8mu}}}} V(X) + V(Y) \end{aligned} \]
※期待値の和は,独立であっても独立でなくても分けられる。
※\(V(XY)=V(X) \cdot V(Y)\)は,独立であろうが独立でなかろうが成り立たない。
\[ \begin{aligned} E(X + Y) &= \class{mathkuu}{\underline{E(X) + E(Y)}}\\ E(aX + bY) &= \class{mathkuu}{\underline{aE(X) + bE(Y)}} \end{aligned} \] 確率変数 \( X \) と \( Y \) が独立であるならば
\[ \begin{aligned} \text{期待値} \quad E(XY) &= \class{mathkuu}{\underline{E(X)E(Y)}} \\ \text{分散} \quad V(X + Y) &= \class{mathkuu}{\underline{V(X) + V(Y)}} \end{aligned} \] 確率変数 \( X \) と \( Y \) が独立でない(従属)ならば
\[ \begin{aligned} \text{期待値} \quad E(XY) &\class{mathkuu}{\underline{\mathrel{\bcancel{\mkern-8mu=\mkern-8mu}}}} E(X)E(Y) \\ \text{分散} \quad V(X + Y) &\class{mathkuu}{\underline{\mathrel{\bcancel{\mkern-8mu=\mkern-8mu}}}} V(X) + V(Y) \end{aligned} \]
※期待値の和は,独立であっても独立でなくても分けられる。
※\(V(XY)=V(X) \cdot V(Y)\)は,独立であろうが独立でなかろうが成り立たない。
Point 2BC 8.2.5 確率変数の和差・積の公式まとめ
下の式も公式として扱うことがある。これまでに習った公式を拡張しているだけなので新たに覚える必要はないが,演習として取り組んでみよう。一番右の列は,各式に登場する確率変数が独立,という条件がなくても成り立つなら○,成り立たないなら×を記せ。
※\(V(XY)=V(X) \cdot V(Y)\)は,独立であろうが独立でなかろうが成り立たない。
\(a,\ b,\ c\) は実数定数とする。確率変数 \( X, \, Y, \, Z, \, X_1, \, X_2, \, \cdots, \, X_n \) に対して,
| 各確率変数が独立なとき | 独立でないときも? | |
| E(X + Y) = | E(X) + E(Y) | ○ |
| V(X + Y) = | V(X) + V(Y) | × |
| E(XY) | E(X) \(\cdot\) E(Y) | × |
| V(XY) | ※ | ※ |
| E(X + Y + Z) = | E(X) + E(Y) + E(Z) | ○ |
| V(X + Y + Z) = | V(X) + V(Y) + V(Z) | × |
| E(aX + bY + c) = | aE(X) + bE(Y) + c | ○ |
| V(aX + bY + c) = | \(a^2\) V(X) + \(b^2\) V(Y) | × |
| E(aX + bY + cZ) = | aE(X) + bE(Y) + cE(Z) | ○ |
| V(aX + bY + cZ) = | \(a^2\) V(X) + \(b^2\) V(Y) + \(c^2\) V(Z) | × |
| E(\(X_1 + X_2 + \cdots + X_n\)) = | E(\(X_1\)) + E(\(X_2\)) + \(\cdots\) + E(\(X_n\)) | ○ |
| V(\(X_1\) + \(X_2\) + \(\cdots\) + \(X_n\)) = | V(\(X_1\)) + V(\(X_2\)) + \(\cdots\) + V(\(X_n\)) | × |
| \(\sigma(X + Y) =\) | \( \sqrt{V(X+Y)}=\sqrt{V(X)+V(Y)=}\sqrt{ (\sigma(X))^2 + (\sigma(Y))^2 }\) | × |
Point 2BC 8.2.6 「\(X,\ Y\)が独立」という問題文をみたら・・・
期待値の積の分解(\(E(XY)=E(X)\cdot E(Y)\))と,分散の和の分解(\(V(X+Y)=V(X)+V(Y)\))の\(2\)式が使えるという意味だと認識!
二項分布
Point 2BC 8.3.1 なぜ「二項」分布?
1個のサイコロを \( n \) 回投げたときに,1の目がでる回数を \( X \) ,\(p = \dfrac{1}{6}, \ q = \dfrac{5}{6}\)とする。
\[
\begin{array}{|c|c|c|c|c|c|c|c|}
\hline
X & 0 & 1 & \cdots & r & \cdots & n & 計 \\
\hline
P & {}_n C_0 q^n & {}_n C_1 pq^{n-1} & \cdots & {}_n C_r p^r q^{n-r} & \cdots & {}_n C_n p^n & 1 \\
\hline
\end{array}
\] この表の確率は,二項定理の展開式
\[ \begin{aligned} (q + p)^n = &\ {}_n C_0 q^n + {}_n C_1 pq^{n-1} + \cdots\\ &+ {}_n C_r p^r q^{n-r} + \cdots + {}_n C_n p^n \end{aligned} \] の各項を順に並べたものになっている。そこでこの確率分布を二項分布と呼び,\( \class{mathkuu}{\underline{B}}(\class{mathkuu}{\underline{n}}, \class{mathkuu}{\underline{p}}) \) で表す。また,確率変数\(X\)は,二項分布\( B(n, p) \)に従う,という。
※Bの由来は,binomial distribution(二項分布)。biが付くと2の意味。bicycleとか。
\[ \begin{aligned} (q + p)^n = &\ {}_n C_0 q^n + {}_n C_1 pq^{n-1} + \cdots\\ &+ {}_n C_r p^r q^{n-r} + \cdots + {}_n C_n p^n \end{aligned} \] の各項を順に並べたものになっている。そこでこの確率分布を二項分布と呼び,\( \class{mathkuu}{\underline{B}}(\class{mathkuu}{\underline{n}}, \class{mathkuu}{\underline{p}}) \) で表す。また,確率変数\(X\)は,二項分布\( B(n, p) \)に従う,という。
※Bの由来は,binomial distribution(二項分布)。biが付くと2の意味。bicycleとか。
Point 2BC 8.3.2 【重要】どんなときに二項分布?
サイコロやコイン,良品・不良品など,毎回の(成功)確率が同じ「反復試行」で,かつ
「結果が成功・失敗など2状態の回数,個数系」ときたら・・・
→二項分布に関する問題を疑え!
「結果が成功・失敗など2状態の回数,個数系」ときたら・・・
→二項分布に関する問題を疑え!
※「さいころの出る目を\(X\)」だと,結果が\(6\)状態で\(2\)状態ではないから二項分布にならない。
※確率統計の問題では,これは何の問題・・・?どの考え方,公式を使うの・・・?を判断するのが難しい。サイコロやコイン以外もあるが,この2つが来た時には特に二項分布かな?じゃあ二項分布のポイントを使っていこう!という発想をまずはしてみよう。
※確率統計の問題では,これは何の問題・・・?どの考え方,公式を使うの・・・?を判断するのが難しい。サイコロやコイン以外もあるが,この2つが来た時には特に二項分布かな?じゃあ二項分布のポイントを使っていこう!という発想をまずはしてみよう。
Point 2BC 8.3.3 「二項分布」ときたら・・・
→試行回数と毎回の(成功)確率の2つの要素を考えよ!
\(\because\)(二項分布は,\( \class{mathkuu}{\underline{B}}(\class{mathkuu}{\underline{n}}, \class{mathkuu}{\underline{p}}) \) で表される。)
Point 2BC 8.3.4 二項分布の期待値・分散・標準偏差
確率変数 \( X \) が二項分布 \( B(n, p) \) に従うとき、\( q = 1 - p \) (すなわち失敗確率!)とすると
\[
\begin{aligned}
\text{期待値} \quad E(X) &= \class{mathkuu}{\underline{np}} \\
\text{分散} \quad V(X) &= \class{mathkuu}{\underline{npq}} \\
\text{標準偏差} \quad \sigma(X) &= \class{mathkuu}{\underline{\sqrt{npq}}}
\end{aligned}
\]
例えば期待値の式は,「毎回の成功確率を\(n\)回」など意味でも理解。
ちなみに分散の式からわかることは,\(p=0.5\)でばらつき最大(\(p\)の2次関数とみて平方完成),\(p=0\) or \(1\)で限りなく小さくなる。 \(p\)が\(0\)や\(1\)に近いときは毎回の結果がほぼ確定しているので,ばらつきが小さくなるのは直感と一致する。逆に\(p=0.5\)のときは毎回の結果が最も読めないので,ばらつきが最大になる。
ちなみに分散の式からわかることは,\(p=0.5\)でばらつき最大(\(p\)の2次関数とみて平方完成),\(p=0\) or \(1\)で限りなく小さくなる。 \(p\)が\(0\)や\(1\)に近いときは毎回の結果がほぼ確定しているので,ばらつきが小さくなるのは直感と一致する。逆に\(p=0.5\)のときは毎回の結果が最も読めないので,ばらつきが最大になる。
正規分布
Point 2BC 8.4.1 二項分布と正規分布の関係
二項分布 \( B(n, p) \) において,試行回数\( n \)を,100回,1000回,・・・とどんどん増やしていくと,正規分布に近づく。
→二項分布 \( B(n, p) \) に従う確率変数 \( X \) は,\( n \) が大きいとき,
近似的に正規分布 \( \class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{np}}, \class{mathkuu}{\underline{npq}}) \) に従う。ただし,\( q = 1 - p \) である。
→二項分布 \( B(n, p) \) に従う確率変数 \( X \) は,\( n \) が大きいとき,
近似的に正規分布 \( \class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{np}}, \class{mathkuu}{\underline{npq}}) \) に従う。ただし,\( q = 1 - p \) である。
Point 2BC 8.4.2 正規分布とその性質
身長や一定の規格で作られた部品の誤差など,自然界や社会において偶然に起こる現象には,正規分布と呼ばれる分布に従うものが多い。
 であるとき,この\(X\)の確率分布を正規分布といい,
\(\boldsymbol{\class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{m}},\ \class{mathkuu}{\underline{\sigma^{2}}})}\)で表す。このとき,\(X\)は正規分布\(\boldsymbol{\class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{m}},\ \class{mathkuu}{\underline{\sigma^{2}}})}\)に従うといい,曲線\(y=f(x)\)を正規分布曲線という。(\(e=2.71828\cdots\cdots\):自然対数)
 ※馴染み深いところでいうと,テストの結果が正規分布に従うとき,偏差値は期待値(平均)50,標準偏差10の\(N(50,\ 10^2)\)で考える。よって,上式から偏差値が40~60の受験者は全体の約68%であり、偏差値が30〜70の受験者は全体の約95%,偏差値70を取ったときには上の結果から自身が上位2.5%\(((100-95)\div 2)\)に入っていることなどが分かる。なので,模試の結果の標準偏差のところに書いてある得点分プラスで取れたら,偏差値が10上がるという仕組みである。
\(m\):実数, \(\sigma\):正の実数で確率変数\(X\)の確率密度関数\(f(x)\)が
\[
f(x)=\dfrac{1}{\sqrt{2\pi}\sigma}e^{-\dfrac{(x-m)^{2}}{2\sigma^{2}}}
\]
\(\boldsymbol{\class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{m}},\ \class{mathkuu}{\underline{\sigma^{2}}})}\)で表す。このとき,\(X\)は正規分布\(\boldsymbol{\class{mathkuu}{\underline{N}}(\class{mathkuu}{\underline{m}},\ \class{mathkuu}{\underline{\sigma^{2}}})}\)に従うといい,曲線\(y=f(x)\)を正規分布曲線という。(\(e=2.71828\cdots\cdots\):自然対数)
※\(N\)の由来:normal distribution(正規分布)
\(X\)が正規分布\(N(m,\ \sigma ^{2})\)に従う確率変数であるとき,
\[
\text{期待値(平均)}E(X)=\class{mathkuu}{\underline{m}} \qquad \text{標準偏差}\sigma(X)=\class{mathkuu}{\underline{\sigma}}
\]
正規分布曲線\(y=f(x)\)の性質:
① 直線\(x=m\)に関して対称な山型の曲線であり,\(x=m\)で\(y\)は最大値をとる。(上式で\(f(m-x)=f(m+x)\))
② \(x\)軸を漸近線とする。
③ 標準偏差\(\sigma\)が大きくなると,曲線の山は低くなって横に広がり,\(\sigma\)が小さくなると,曲線の山は高くなって対称軸\(x=m\)のまわりに集まる。
④ (標準でなくとも)任意の正規分布で以下が成り立つ。 \[1\sigma \ :P(m - \sigma \leqq X \leqq m + \sigma) \fallingdotseq 0.6827\] \[2\sigma \ :P(m - 2\sigma \leqq X \leqq m + 2\sigma) \fallingdotseq 0.9545\] \[3\sigma \ :P(m - 3\sigma \leqq X \leqq m + 3\sigma) \fallingdotseq 0.9973\]
② \(x\)軸を漸近線とする。
③ 標準偏差\(\sigma\)が大きくなると,曲線の山は低くなって横に広がり,\(\sigma\)が小さくなると,曲線の山は高くなって対称軸\(x=m\)のまわりに集まる。
④ (標準でなくとも)任意の正規分布で以下が成り立つ。 \[1\sigma \ :P(m - \sigma \leqq X \leqq m + \sigma) \fallingdotseq 0.6827\] \[2\sigma \ :P(m - 2\sigma \leqq X \leqq m + 2\sigma) \fallingdotseq 0.9545\] \[3\sigma \ :P(m - 3\sigma \leqq X \leqq m + 3\sigma) \fallingdotseq 0.9973\]
Point 2BC 8.4.3 「正規分布」ときたら・・・
→グラフの「山の位置と,そこから変曲点までの距離(形)」,
すなわち平均と標準偏差(の2乗)の2つの要素を考えよ!

Point 2BC 8.4.4 標準正規分布
正規分布\(N(0,\ 1)\)を標準正規分布といい,確率密度関数は次のようになる。
\[
f(z)=\dfrac{1}{\sqrt{2\pi}}e^{-\frac{z^{2}}{2}}
\]
この分布曲線\(y=f(z)\)は,\(y\)軸に関して対称な山型の曲線であり,\(z=0\)で\(y\)は最大値をとり,\(z\)軸を漸近線とする。

Point 2BC 8.4.5 正規分布表
標準正規分布 \( N(\class{mathkuu}{\underline{0}}, \class{mathkuu}{\underline{1}}) \) にしたがう確率変数 \( Z \) に対して,確率 \( P(0 \leqq Z \leqq u) \) を,\( u \) のいろいろな値に対して計算して表にまとめたものを 正規分布表 という。
Point 2BC 8.4.6 標準化
確率変数 \( X \) が正規分布 \( N(m, \sigma^2) \) に従うとき、\( Z = \class{mathkuu}{\underline{\dfrac{X - m}{\sigma}}} \) とおくと、
確率変数 \( Z \) は標準正規分布 \( N(\class{mathkuu}{\underline{0}}, \class{mathkuu}{\underline{1}}) \) に従う。
Point 2BC 8.4.7 標準化のメリット
なんのために標準化する・・・?
→正規分布表が使えるようになる!
→確率が読み取れる!

Point 2BC 8.4.8 \( Z = X - m{\sigma} \) の意味について
\( Z = \dfrac{X - m}{\sigma} \)の式が苦手な人が多いが,日本語で理解すれば怖くない。データの平均値を0にするために,まずはすべてのデータの値から平均値の\(m\)を引く!
次に,標準偏差を\(\sigma\)から1にしたい。データの分析の変量変換の式を思い出すと,各データの値を\(a\)倍するとデータの分散は2乗で効いてくるので,分散は\(a^2\)倍に。すなわち,標準偏差は\(|a|\)倍に。ゆえに,標準偏差を\(\sigma\)から1に\(\dfrac{1}{\sigma}\)倍するには,\(\sigma\)で割る!
(元々\(\sigma\)は正だから絶対値のプラマイは深く考えなくてOK。)

直線が「通る点(位置)」と「傾き(形)」で描ける(式が決まる)ように、放物線が「頂点(位置)」と「\( x^2 \) の係数(形)」で描ける(式が決まる)ように、正規分布も「平均値(位置)」と「標準偏差(形)」で描ける。
次に,標準偏差を\(\sigma\)から1にしたい。データの分析の変量変換の式を思い出すと,各データの値を\(a\)倍するとデータの分散は2乗で効いてくるので,分散は\(a^2\)倍に。すなわち,標準偏差は\(|a|\)倍に。ゆえに,標準偏差を\(\sigma\)から1に\(\dfrac{1}{\sigma}\)倍するには,\(\sigma\)で割る!
(元々\(\sigma\)は正だから絶対値のプラマイは深く考えなくてOK。)
\[標準化:\dfrac{(データの値)-(平均)}{(標準偏差)}\]
放物線で考えるともっとわかりやすい。例えば,頂点の位置が\((2,\ 0)\)で,\(x^2\)の係数が\(\dfrac{1}{5}\)と少し太めの形をした\(y=\dfrac{1}{5}(x-2)^2\)を,放物線の中で最も「標準」と言える\(y=x^2\)に変えることを考えよう。頂点の位置を\((2,\ 0)\)から\((0,\ 0)\)に変え,放物線の形を表す\(x^2\)の係数\(\dfrac{1}{5}\)を\(1\)に変えたい。(拡大・縮小はあまり高校で扱わないので少し難しいが,)\(x\)を\(Z=\dfrac{x-2}{\sqrt{5}}\)と置き換えれば,元の式は\(y=Z^2\)となる。これが標準化である。
同様に正規分布においても,色々な山の位置やグラフの形(変曲点の位置)をしているものを標準的な,「山の位置が0で形を表す標準偏差が1」である標準正規分布に変換する。なぜその必要があるかと言うと,「ここからここまでの確率はいくつです」という数値をまとめた表を色々な山の位置・形をした全ての正規分布において用意するのは現実的でないからである。「標準正規分布だったらここからここまでの確率がいくつだよ」という基本の表だけ準備しておけば,どんな正規分布が来ても標準化して帰着させることで対応ができる。
| 位置 | 形 | 式 | |
| 直線 | 通る点 \( ({\color{blue}{p}}, {\color{blue}{q}}) \) | 傾き \( {\color{red}{m}} \) | \( y = {\color{red}{m}}(x - {\color{blue}{p}}) + {\color{blue}{q}} \) |
| 放物線 | 頂点 \( ({\color{blue}{p}}, {\color{blue}{q}}) \) | \( x^2 \) の係数 \( {\color{red}{a}} \) | \( y = {\color{red}{a}}(x - {\color{blue}{p}})^2 + {\color{blue}{q}} \) |
| 正規分布曲線 | 平均値 \( {\color{blue}{m}} \) | 標準偏差 \( {\color{red}{\sigma}} \) (分散 \( {\color{red}{\sigma}}^2 \)) | \( y = \frac{1}{\sqrt{2\pi} {\color{red}{\sigma}}} e^{-\frac{(x - {\color{blue}{m}})^2}{2{\color{red}{\sigma}}^2}} \) |
確率密度関数
Point 2BC 8.5.1 確率密度関数とその性質
連続的な値をとる確率変数 \( X \) を連続型確率変数といい,飛び飛びの値をとる確率変数 \( X \) を離散型確率変数という。
連続型確率変数 \( X \) が \( a \) 以上 \( b \) 以下の値をとる確率を \( P(a \leqq X \leqq b) \) で表す。 \( a \leqq X \leqq b \) の範囲にある連続的な確率変数 \( X \) について,次の性質の関数 \( f(x) \) を対応させる。
[1] \( f(x) \class{mathkuu}{\underline{\geqq}} 0 \)
[2] 確率 \( P(a \leqq X \leqq b) \) は, \[ P(a \leqq X \leqq b) = \class{mathkuu}{\underline{\int_a^b f(x) \, dx}} \] この関数 \( f(x) \) を \( X \) の確率密度関数,曲線 \( y = f(x) \) を分布曲線という。 連続的な確率変数 \( X \) のとり得る値の範囲が \( \alpha \leqq X \leqq \beta \) のとき, \[ P(\alpha \leqq X \leqq \beta) = \int_\alpha^\beta f(x) \, dx = \class{mathkuu}{\underline{1}} \] \[ P(X = a) = \class{mathkuu}{\underline{0}}\ \ \left( \because \ \ =\int_a^a f(x) \, dx \right) \] \(P(X = a) = 0\)より,具体的な数値で例を挙げると,\(P\left( X = \frac{3}{2}\right) = 0\) であるから, \[P\left( \frac{1}{2} \leqq X < \frac{3}{2}\right) = P\left( \frac{1}{2} \leqq X \leqq \frac{3}{2}\right)\] のように等号の有無で値は変わらない。
(高校数学においては区間の端における微積分はあまり深く考えなくてよい。)
[1] \( f(x) \class{mathkuu}{\underline{\geqq}} 0 \)
[2] 確率 \( P(a \leqq X \leqq b) \) は, \[ P(a \leqq X \leqq b) = \class{mathkuu}{\underline{\int_a^b f(x) \, dx}} \] この関数 \( f(x) \) を \( X \) の確率密度関数,曲線 \( y = f(x) \) を分布曲線という。 連続的な確率変数 \( X \) のとり得る値の範囲が \( \alpha \leqq X \leqq \beta \) のとき, \[ P(\alpha \leqq X \leqq \beta) = \int_\alpha^\beta f(x) \, dx = \class{mathkuu}{\underline{1}} \] \[ P(X = a) = \class{mathkuu}{\underline{0}}\ \ \left( \because \ \ =\int_a^a f(x) \, dx \right) \] \(P(X = a) = 0\)より,具体的な数値で例を挙げると,\(P\left( X = \frac{3}{2}\right) = 0\) であるから, \[P\left( \frac{1}{2} \leqq X < \frac{3}{2}\right) = P\left( \frac{1}{2} \leqq X \leqq \frac{3}{2}\right)\] のように等号の有無で値は変わらない。
(高校数学においては区間の端における微積分はあまり深く考えなくてよい。)
Point 2BC 8.5.2 確率密度関数の期待値・分散・標準偏差
確率変数を \( X (\alpha \leqq X \leqq \beta) \),その確率密度関数を \( f(x) \) とすると, \[
\begin{aligned}
\text{期待値} \quad E(X) &= \class{mathkuu}{\underline{\int_{\alpha}^{\beta} x f(x) \, dx}} \quad (= m) \\
\text{分散} \quad V(X) &= \class{mathkuu}{\underline{\int_{\alpha}^{\beta} (x - m)^2 f(x) \, dx}} \\
\text{標準偏差} \quad \sigma(X) &= \class{mathkuu}{\underline{\sqrt{V(X)}}}
\end{aligned}
\]
※\(V(X)\)を計算すると, \[
\begin{aligned}
V(X)&= \int_{\alpha}^{\beta} (x - m)^2 f(x) \, dx\\
&= \int_{\alpha}^{\beta} x^2 f(x) \, dx - 2m{\color{red}{\int_{\alpha}^{\beta} x f(x) \, dx}}\\
&\qquad +m^2{\color{blue}{\int_{\alpha}^{\beta} f(x) \, dx}}\\
&= \class{mathkuu}{\underline{\int_{\alpha}^{\beta} x^2 f(x) \, dx -m^2}}
\end{aligned}
\]
\(\because\) 期待値の式より \({\color{red}{\displaystyle\int_{\alpha}^{\beta} x f(x) \, dx}} = m\),かつ \({\color{blue}{\displaystyle\int_{\alpha}^{\beta} f(x) \, dx}}=1\)
と整理することもできる。つまり,分散公式②「(2乗の平均)-(平均の2乗)」が成り立つ!
Point 2BC 8.5.3 正規分布表を使う\(3\)つのテクニック
正規分布表に載っているのは「\(0\)から\(z\)まで」の面積だけ。そこで,欲しい面積を表に載っている形の足し引きで作る。使う道具は\(3\)つ。 ① 全体の面積は\(1\),左右対称だから片側は\(0.5\)。この\(0.5\)が計算の出発点になることが非常に多い。
② 技1:くり抜き\(\cdots\)「\(0.5\)」や「\(0\)から\(b\)まで」といった大きい面積から,いらない部分を引く。\(z\)より右側の確率なら\(0.5-(\text{表の値})\)。
③ 技2:折り返し\(\cdots\)負の側は,対称性を使って正の側に折り返す。\(P(-a\leqq Z\leqq 0)=P(0\leqq Z\leqq a)\)なので,表にない負の値もそのまま読める。
② 技1:くり抜き\(\cdots\)「\(0.5\)」や「\(0\)から\(b\)まで」といった大きい面積から,いらない部分を引く。\(z\)より右側の確率なら\(0.5-(\text{表の値})\)。
③ 技2:折り返し\(\cdots\)負の側は,対称性を使って正の側に折り返す。\(P(-a\leqq Z\leqq 0)=P(0\leqq Z\leqq a)\)なので,表にない負の値もそのまま読める。
\(0.5\)・くり抜き・折り返しの\(3\)つで攻めよう!
標本調査と標本平均
ここからの\(3\)節は「母集団と標本」,「推定」,「(仮説)検定」がメインテーマ!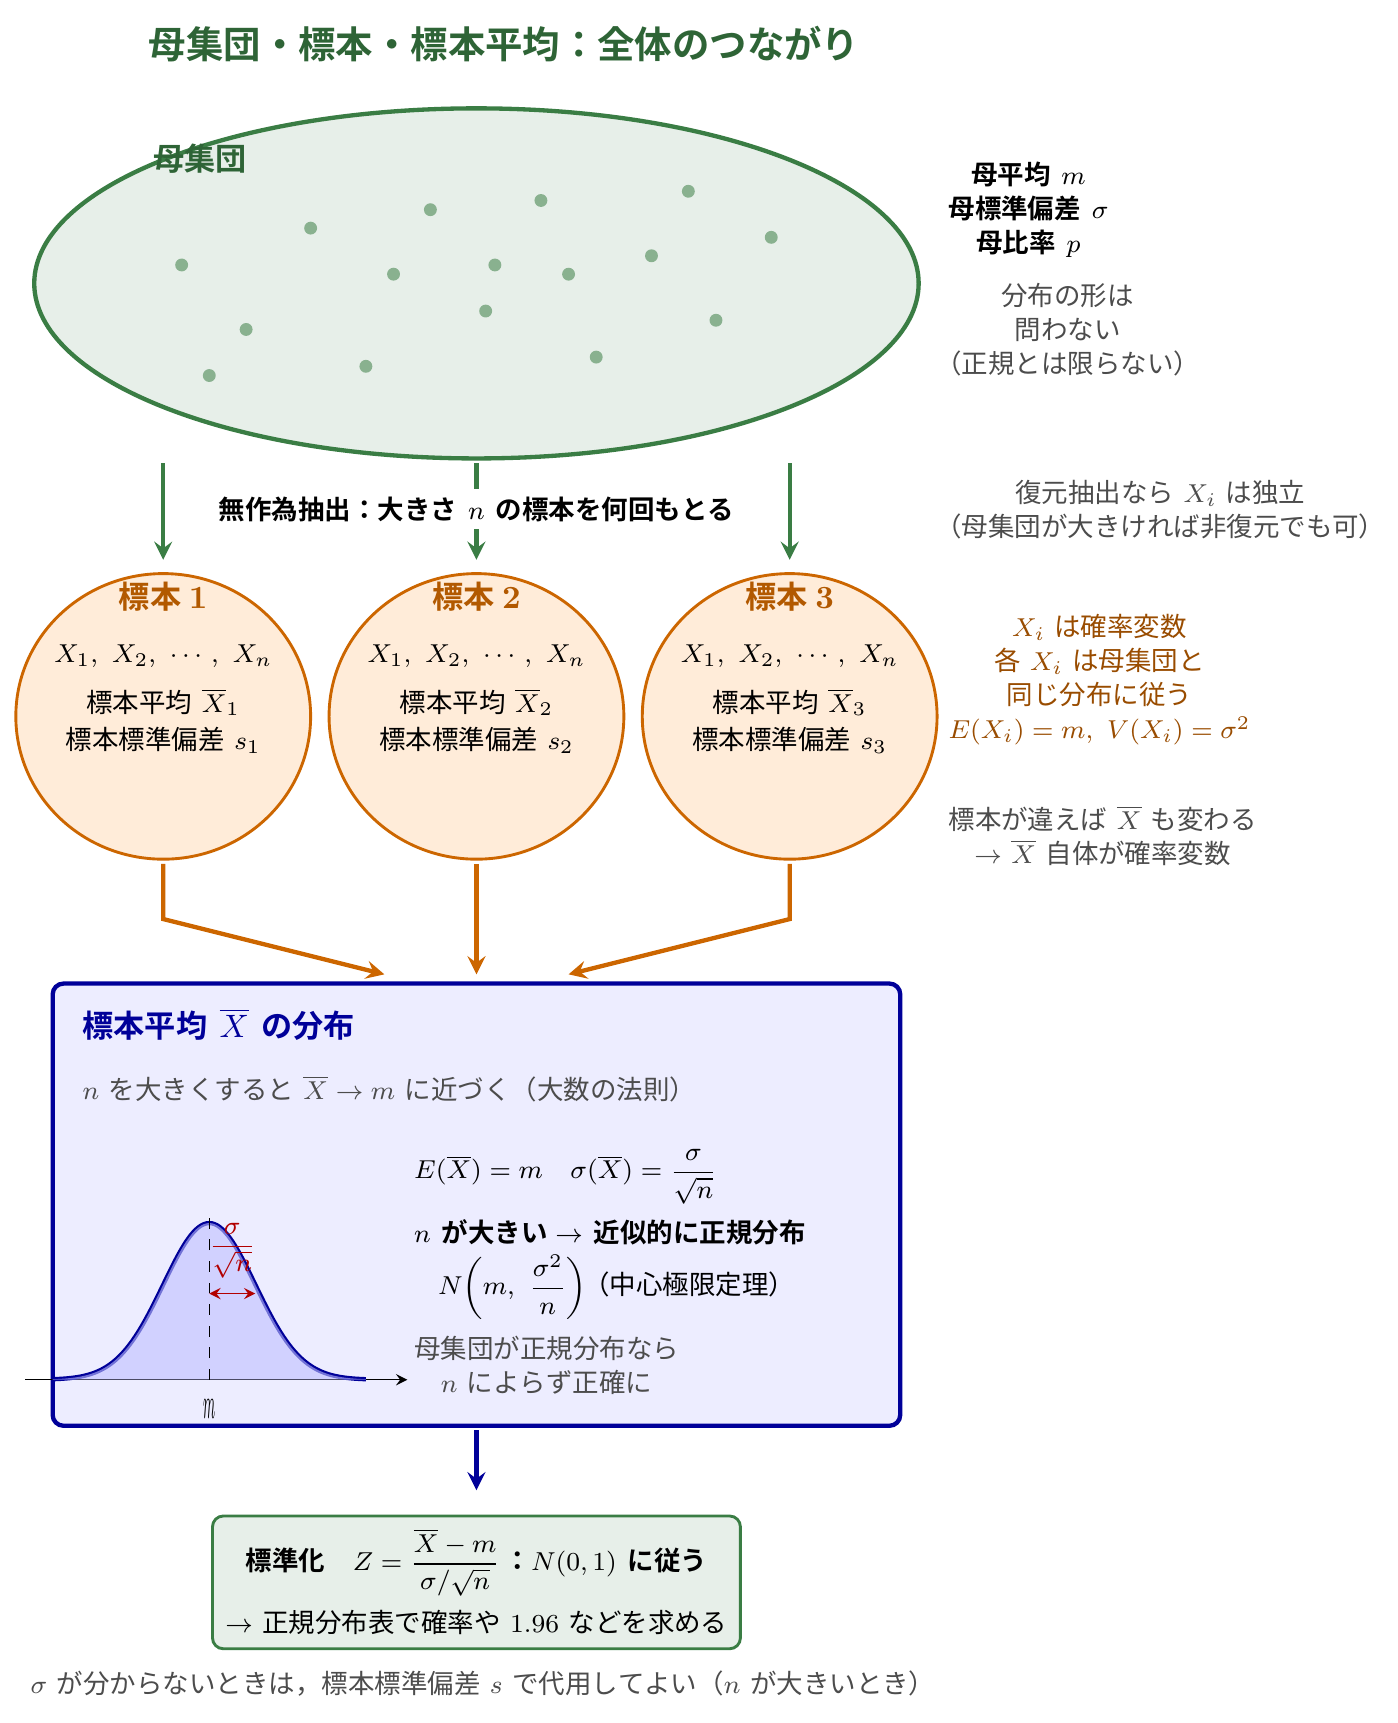
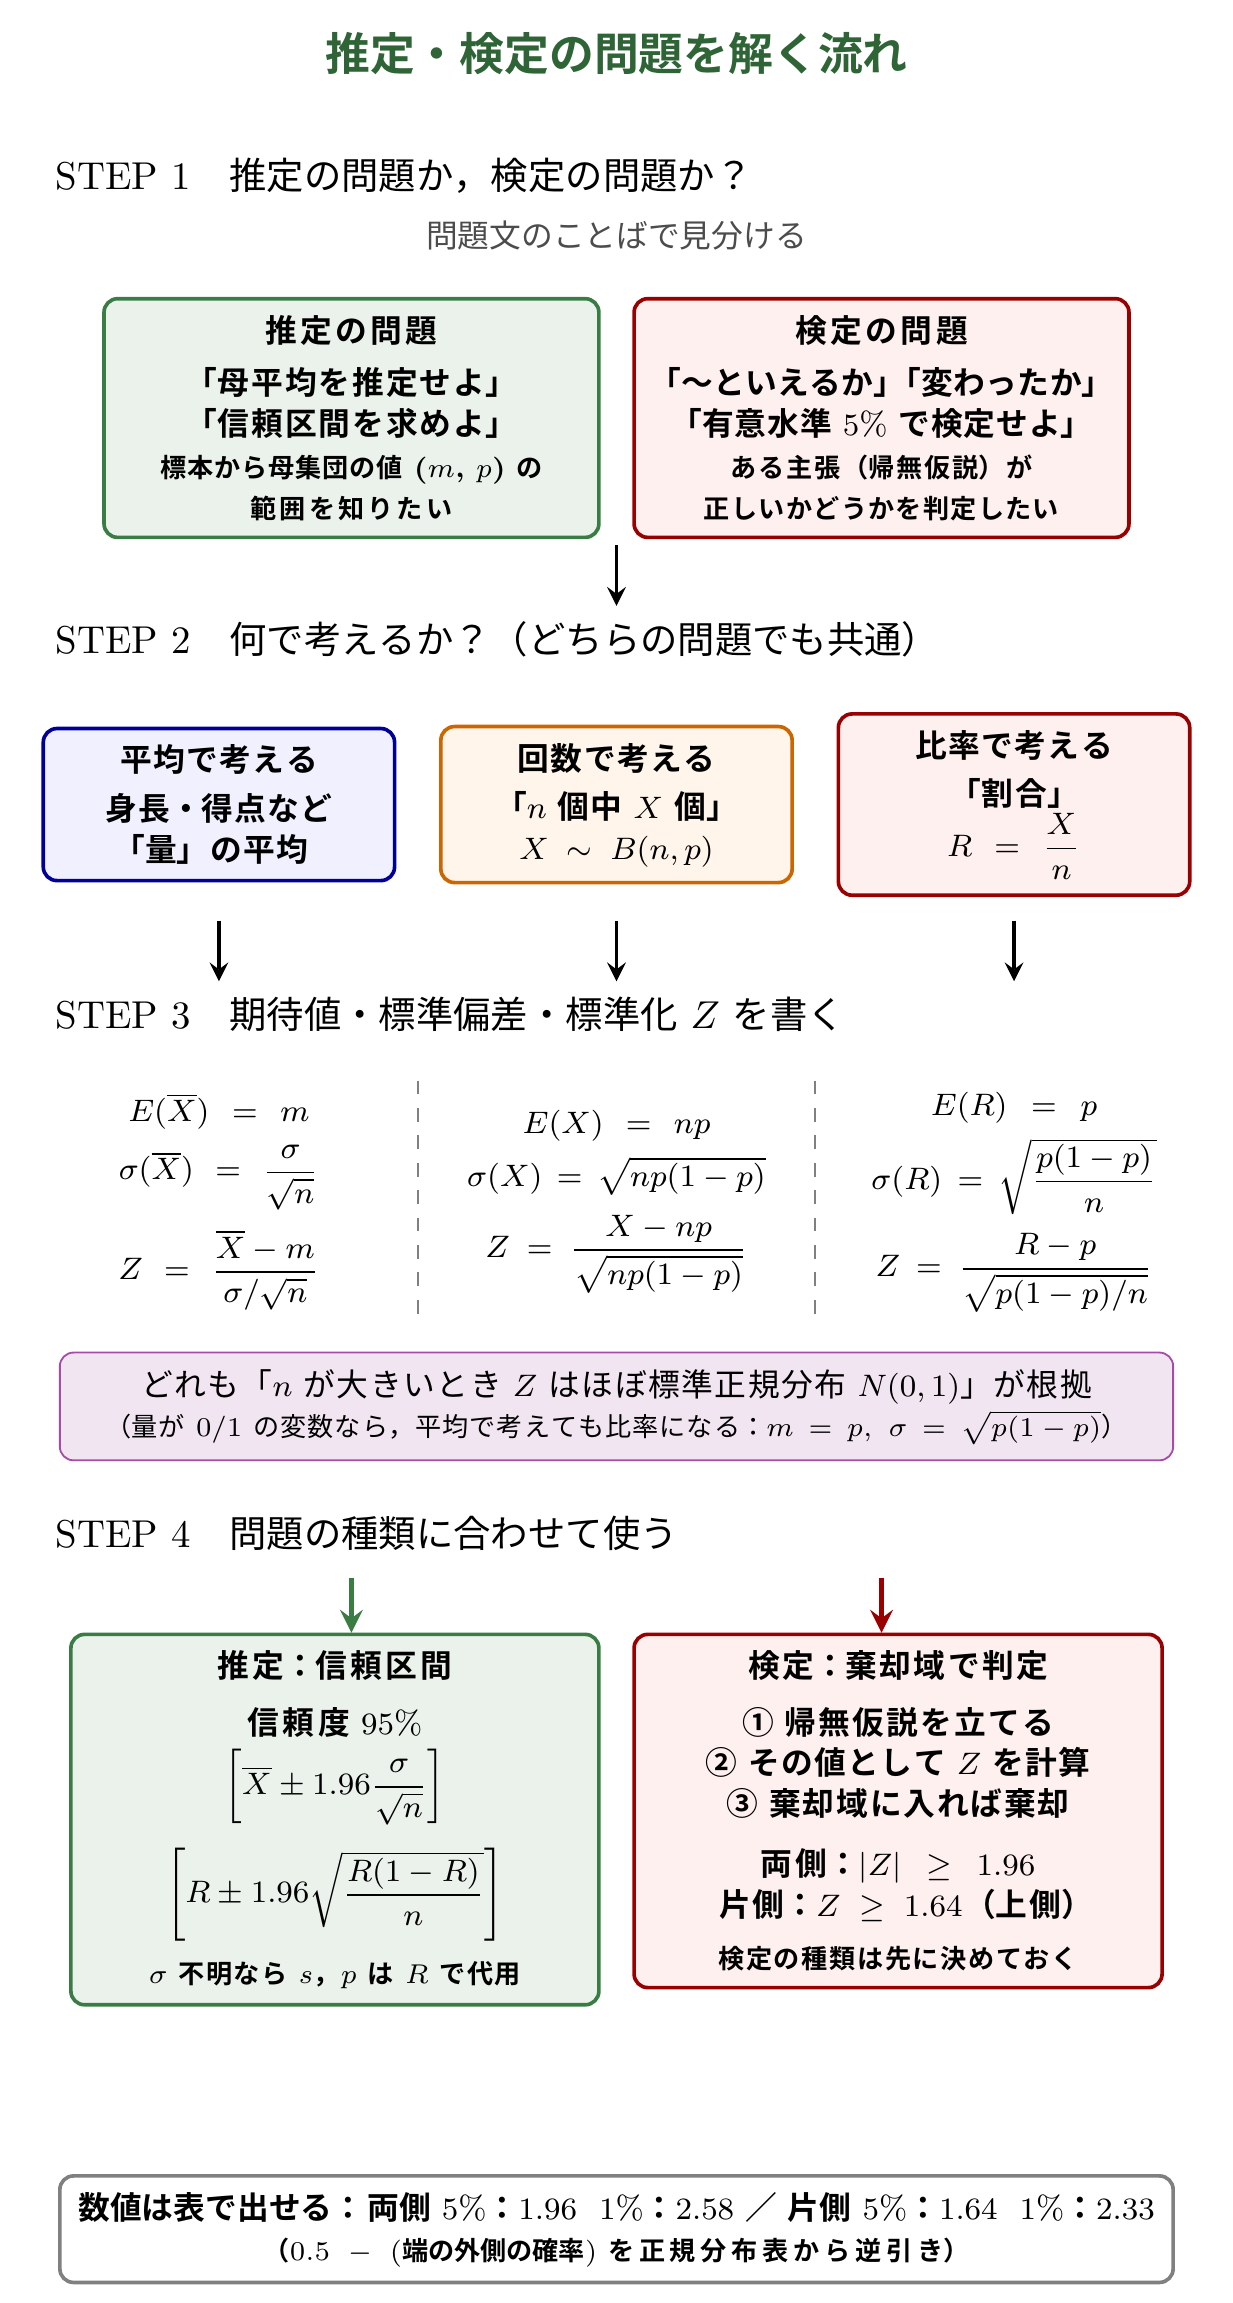
母集団と標本
Point 2BC 8.6.1 基本用語まとめ
・標本調査
統計調査には,調査の対象全体をもれなく調べる全数調査と,対象全体から一部を抜き出して調べ,それから全体を推測する標本調査の2通りの方法がある。 ・母集団と標本
標本調査では,調査の対象全体を母集団といい,調査のために母集団から抜き出された要素の全体を標本といい,標本を抜き出すことを抽出といい,母集団,標本に含まれる要素の個数を,それぞれ母集団の大きさ,標本の大きさという。 ・無作為抽出と無作為標本
母集団の特徴を正しく推測するためには,標本にかたよりがなく,確率的にみて公平な抽出をしなければならない。そのために,乱数賽(特定なさいころ),乱数表,コンピュータで発生させた乱数を利用する。このような抽出方法を無作為抽出(または任意抽出)といい,無作為抽出によって選ばれた標本を無作為標本という。 ・復元抽出と非復元抽出
母集団から標本を抽出するとき,抽出のたびに要素をもとに戻し,あらためて次を抽出する方法を復元抽出という。一方,もとに戻さないで,続けて抽出する方法を非復元抽出という。 母集団から抽出された大きさ\(n\)の無作為標本 \((X_1, X_2, \ldots, X_n)\) が,復元抽出によって得られたものであれば,\(X_1, X_2, \ldots, X_n\) は独立である。また,非復元抽出によるものであれば,\(X_1, X_2, \ldots, X_n\) は独立ではない。 ただし,母集団の要素の数がきわめて大きいときには,非復元抽出でも,\(X_1, X_2, \ldots, X_n\) が独立であるとみなしてよいことが知られている。 ・母平均と標本平均
母集団分布においての平均を母平均,標準偏差を母標準偏差という。 母平均\(m\),母標準偏差\(\sigma\)の母集団から大きさ\(n\)の無作為標本 \((X_1, X_2, \ldots, X_n)\)を抽出するとき,\(\dfrac{1}{n}(X_1 + X_2 + \cdots + X_n)\)を標本平均といい,\(\overline{X}\)で表す。
統計調査には,調査の対象全体をもれなく調べる全数調査と,対象全体から一部を抜き出して調べ,それから全体を推測する標本調査の2通りの方法がある。 ・母集団と標本
標本調査では,調査の対象全体を母集団といい,調査のために母集団から抜き出された要素の全体を標本といい,標本を抜き出すことを抽出といい,母集団,標本に含まれる要素の個数を,それぞれ母集団の大きさ,標本の大きさという。 ・無作為抽出と無作為標本
母集団の特徴を正しく推測するためには,標本にかたよりがなく,確率的にみて公平な抽出をしなければならない。そのために,乱数賽(特定なさいころ),乱数表,コンピュータで発生させた乱数を利用する。このような抽出方法を無作為抽出(または任意抽出)といい,無作為抽出によって選ばれた標本を無作為標本という。 ・復元抽出と非復元抽出
母集団から標本を抽出するとき,抽出のたびに要素をもとに戻し,あらためて次を抽出する方法を復元抽出という。一方,もとに戻さないで,続けて抽出する方法を非復元抽出という。 母集団から抽出された大きさ\(n\)の無作為標本 \((X_1, X_2, \ldots, X_n)\) が,復元抽出によって得られたものであれば,\(X_1, X_2, \ldots, X_n\) は独立である。また,非復元抽出によるものであれば,\(X_1, X_2, \ldots, X_n\) は独立ではない。 ただし,母集団の要素の数がきわめて大きいときには,非復元抽出でも,\(X_1, X_2, \ldots, X_n\) が独立であるとみなしてよいことが知られている。 ・母平均と標本平均
母集団分布においての平均を母平均,標準偏差を母標準偏差という。 母平均\(m\),母標準偏差\(\sigma\)の母集団から大きさ\(n\)の無作為標本 \((X_1, X_2, \ldots, X_n)\)を抽出するとき,\(\dfrac{1}{n}(X_1 + X_2 + \cdots + X_n)\)を標本平均といい,\(\overline{X}\)で表す。
Point 2BC 8.6.2 母集団と標本の平均・標準偏差
母平均 \( m \),母標準偏差 \( \sigma \) の母集団から大きさ \( n \) の無作為標本を抽出するとき,標本平均 \( \overline{X} \) の期待値と標準偏差は
\[
\begin{aligned}
E(\overline{X}) &= \class{mathkuu}{\underline{m}}\\
V(\overline{X}) &= \class{mathkuu}{\underline{\dfrac{\sigma ^2}{n}}}\\
\sigma(\overline{X}) &= \class{mathkuu}{\underline{\dfrac{\sigma}{\sqrt{n}}}}
\end{aligned}
\]
※標本分散は,母分散の\(\dfrac{1}{n}\)倍(\(n\)は標本の大きさ)が覚えやすい。
※標本平均の平均ってなんだ?とおもうが,標本もとるごとに毎回平均が異なる,「確率変数」であるから,その期待値のこと。「標本平均の平均」より,「標本平均の期待値」と認識しよう。
※標本平均の平均ってなんだ?とおもうが,標本もとるごとに毎回平均が異なる,「確率変数」であるから,その期待値のこと。「標本平均の平均」より,「標本平均の期待値」と認識しよう。
Point 2BC 8.6.3 大数の法則
母平均 \( m \) の母集団から,大きさ \( n \) の標本を無作為抽出するとき,\( n \) を大きくしていくと,標本平均 \( \overline{X} \) は(母平均) \( m \) に近づく。
簡単に言えば,たくさん実験すればデータの平均は真の平均に近づくという法則
Point 2BC 8.6.4 標本平均の分布
母平均 \( m \),母標準偏差 \( \sigma \) の母集団から大きさ \( n \) の無作為標本を抽出するとき,標本平均 \( \overline{X} \) は,\( n \) が大きいとき,母集団分布が正規分布でなくても!近似的に\(\class{mathkuu}{\underline{正規}}\)分布 \( \class{mathkuu}{\underline{N}}\left( \class{mathkuu}{\underline{m}}, \class{mathkuu}{\underline{\dfrac{\sigma^2}{n}}} \right) \) に従うとみなせる。(すごい事実。イメージはPoint8.6.5参照。) この事実を中心極限定理という。高校では証明はせず,認めて使う(大学で学ぶ)。名前を知らなくても解けるが,推定・検定がすべてこの定理の上に乗っていることは意識しておこう。
母集団が正規分布の場合,標本平均 \( \overline{X} \) の分布は \(n\)の大きさに関わらず正確に
正規分布 \( \class{mathkuu}{\underline{N}}\left( \class{mathkuu}{\underline{m}}, \class{mathkuu}{\underline{\dfrac{\sigma^2}{n}}} \right) \) に従う。
Point 2BC 8.6.5 \(n\)が大きいとき標本平均が正規分布に近づくことのイメージ
サイコロで考えてみよう。まず言葉の対応を確認する。
- サイコロ\(1\)個の出目の分布(\(1\)〜\(6\)が各\(\dfrac{1}{6}\))\(\cdots\)母集団分布(=もとの分布)
- サイコロを\(n\)個振って出た\(n\)個の目 \(\cdots\)標本(この\(n\)が標本の大きさ)
- その\(n\)個の平均 \(\cdots\)標本平均\(\overline{X}\)
Point 2BC 8.6.6 標本平均の標準化
上のことから,標本平均 \( \overline{X} \) について,\( n \) が大きいとき,\( Z = \class{mathkuu}{\underline{\dfrac{\overline{X} - m}{\frac{\sigma}{\sqrt{n}}}}} \) とすれば,ほぼ標準正規分布 \( N(0, 1) \) とみなすことができ,標本平均を標準化できる。
推定
推定:母集団全てを調査することは大変なので,抽出された標本から母集団の分布などを推測する。推定
Point 2BC 8.7.1 母平均の推定 〜信頼区間〜
与えられた標本から,母集団の平均や標準偏差など母集団の分布がもつ定数の値を推測することを推定という。
標本の大きさ \( n \) が大きいとき、(←「標本平均は正規分布に従うとみなせるよ」という意味)
母平均 \( m \)に対する信頼度95%の信頼区間は,標本平均 \( \overline{X} \) ,母標準偏差 \( \sigma \)とすると, \[ \left[ \class{mathkuu}{\underline{\overline{X} - 1.96 \cdot \dfrac{\sigma}{\sqrt{n}}}}, \quad \class{mathkuu}{\underline{\overline{X} + 1.96 \cdot \dfrac{\sigma}{\sqrt{n}}}} \right] \] 信頼度99%の信頼区間は \[ \left[ \class{mathkuu}{\underline{\overline{X} - 2.58 \cdot \dfrac{\sigma}{\sqrt{n}}}}, \quad \class{mathkuu}{\underline{\overline{X} + 2.58 \cdot \dfrac{\sigma}{\sqrt{n}}}} \right] \]
母平均 \( m \)に対する信頼度95%の信頼区間は,標本平均 \( \overline{X} \) ,母標準偏差 \( \sigma \)とすると, \[ \left[ \class{mathkuu}{\underline{\overline{X} - 1.96 \cdot \dfrac{\sigma}{\sqrt{n}}}}, \quad \class{mathkuu}{\underline{\overline{X} + 1.96 \cdot \dfrac{\sigma}{\sqrt{n}}}} \right] \] 信頼度99%の信頼区間は \[ \left[ \class{mathkuu}{\underline{\overline{X} - 2.58 \cdot \dfrac{\sigma}{\sqrt{n}}}}, \quad \class{mathkuu}{\underline{\overline{X} + 2.58 \cdot \dfrac{\sigma}{\sqrt{n}}}} \right] \]
導出
標本の大きさ \( n \) が大きいとき,\( Z \) の値がある範囲にある確率は,正規分布表から求めることができる。 たとえば,95% となる範囲は,\( P(|Z| \leqq 1.96) = 0.4750 \times 2 = 0.95 \)
\( Z \) は,\( Z = \dfrac{\overline{X} - m}{\frac{\sigma}{\sqrt{n}}} \) であるから,\( |Z| \leqq 1.96 \) は,
 が導かれる。信頼区間99% についても同様。区間を表すため,\([\ ,\ ]\)の書き方をすることが多いが,これは\(m\)の両端を表していることを忘れないように。
※この1.96は2に近い値であることを当たり前と思えるだろうか。Point8.4.2にあるように,任意の正規分布で,2\(\sigma\)の範囲にある確率は約95.45% (偏差値でいうと,\(2\sigma =20\)なので偏差値30〜70の確率)。であるから,2弱であるのは当然である。
標本の大きさ \( n \) が大きいとき,\( Z \) の値がある範囲にある確率は,正規分布表から求めることができる。 たとえば,95% となる範囲は,\( P(|Z| \leqq 1.96) = 0.4750 \times 2 = 0.95 \)
\( Z \) は,\( Z = \dfrac{\overline{X} - m}{\frac{\sigma}{\sqrt{n}}} \) であるから,\( |Z| \leqq 1.96 \) は,
より,
\[
\begin{aligned}
&\left| \frac{\overline{X} - m}{\frac{\sigma}{\sqrt{n}}} \right| \leqq 1.96 \\[2pt]
&-1.96 \leqq \frac{\overline{X} - m}{\frac{\sigma}{\sqrt{n}}} \leqq 1.96
\end{aligned}
\]
ここから,
\[
\begin{aligned}
\overline{X} - 1.96 \cdot \frac{\sigma}{\sqrt{n}} \leqq\ &m\\
\leqq\ &\overline{X} + 1.96 \cdot \frac{\sigma}{\sqrt{n}}
\end{aligned}
\]
※この1.96は2に近い値であることを当たり前と思えるだろうか。Point8.4.2にあるように,任意の正規分布で,2\(\sigma\)の範囲にある確率は約95.45% (偏差値でいうと,\(2\sigma =20\)なので偏差値30〜70の確率)。であるから,2弱であるのは当然である。
母標準偏差\(\sigma\) の値は普通はわからないので,標本の大きさ \( n \) が大きいときには,\(\sigma\) を標本の標準偏差の値 \( s \) によって置き換えてもよく,次のことが知られている。
母平均 \( m \) に対する信頼度95%および99%の信頼区間は,標本の大きさ \( n \) が大きいとき,標本平均の値を \(\overline{X}\),標本の標準偏差の値を \( s \) とすると, \[ \begin{aligned} 95\%\ &:\left[ \overline{X} - 1.96 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}},\ \ \overline{X} + 1.96 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}} \right]\\[2pt] 99\%\ &:\left[ \overline{X} - 2.58 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}},\ \ \overline{X} + 2.58 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}} \right] \end{aligned} \]
母平均 \( m \) に対する信頼度95%および99%の信頼区間は,標本の大きさ \( n \) が大きいとき,標本平均の値を \(\overline{X}\),標本の標準偏差の値を \( s \) とすると, \[ \begin{aligned} 95\%\ &:\left[ \overline{X} - 1.96 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}},\ \ \overline{X} + 1.96 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}} \right]\\[2pt] 99\%\ &:\left[ \overline{X} - 2.58 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}},\ \ \overline{X} + 2.58 \cdot \frac{{\color{blue}{s}}}{\sqrt{n}} \right] \end{aligned} \]
Point 2BC 8.7.2 【参考】信頼区間について
標本平均\(\overline{X}\)は,抽出のたびに変わる変量であるから,信頼区間も標本抽出のたびに変わる。すなわち,図の\(\mathrm{I},\ \mathrm{II},\ \cdots\cdots\)のように,標本抽出のたびに信頼区間は変わる。このとき,図の\(\overline{X}_{\mathrm{III}}\)のように信頼区間が母平均\(m\)を含まないこともある。
信頼度95%の信頼区間とは,95%の確率で信頼区間が\(m\)を含むという意味であり,100回の標本抽出において,95回くらいは求めた信頼区間が\(m\)を含むということである。
信頼度95%の信頼区間とは,95%の確率で信頼区間が\(m\)を含むという意味であり,100回の標本抽出において,95回くらいは求めた信頼区間が\(m\)を含むということである。

Point 2BC 8.7.3 母比率の推定
標本の大きさ \( n \) が大きいとき,標本比率を \( R \) とすると,
母比率 \( p \) に対する信頼度95%の信頼区間は \[ \left[ \class{mathkuu}{\underline{R - 1.96 \cdot\sqrt{\dfrac{R(1 - R)}{n}}}}, \quad \class{mathkuu}{\underline{R + 1.96 \cdot\sqrt{\dfrac{R(1 - R)}{n}}}} \right] \]
母比率 \( p \) に対する信頼度95%の信頼区間は \[ \left[ \class{mathkuu}{\underline{R - 1.96 \cdot\sqrt{\dfrac{R(1 - R)}{n}}}}, \quad \class{mathkuu}{\underline{R + 1.96 \cdot\sqrt{\dfrac{R(1 - R)}{n}}}} \right] \]
Point 2BC 8.7.4 【参考】 母比率の推定の公式について
母比率 \( p \) の母集団から \( n \) 個取り出して標本をつくるとき,求める性質をもつ個数を \( X \) とすると \( X \) は二項分布 \( B(n, p) \) に従うから,
\[
E(X) = np, \qquad V(X) = np(1 - p)
\]
標本比率は \( R = \dfrac{X}{n} \) であり
\[
\begin{aligned}
E\left( \dfrac{X}{n} \right) &= \dfrac{1}{n} E(X) = \dfrac{1}{n} \cdot np = p\\
V\left( \dfrac{X}{n} \right) &= \dfrac{1}{n^2} V(X) = \dfrac{p(1 - p)}{n}
\end{aligned}
\]
\( n \) が十分に大きいとき,\( B(n, p) \) は近似的に \( N(np, np(1 - p)) \) に従うので,\( R = \dfrac{X}{n} \) は,\( N\left( p, \dfrac{p(1 - p)}{n} \right) \) に従う。
そしてさらに\( n \) が十分に大きいとき,標本比率 \(R\) は母比率 \(p\) に近いとみなしてよいことが知られている。よって,信頼度95% の信頼区間は, \[ P\left(R-1.96\times \sqrt{\dfrac{p(1-p)}{n}}\leqq p\leqq R+1.96\times \sqrt{\dfrac{p(1-p)}{n}}\right)=0.95 \] の不等式部分において\(p\)を\(R\)に置き換えれば推定の信頼区間の式が得られる。
そしてさらに\( n \) が十分に大きいとき,標本比率 \(R\) は母比率 \(p\) に近いとみなしてよいことが知られている。よって,信頼度95% の信頼区間は, \[ P\left(R-1.96\times \sqrt{\dfrac{p(1-p)}{n}}\leqq p\leqq R+1.96\times \sqrt{\dfrac{p(1-p)}{n}}\right)=0.95 \] の不等式部分において\(p\)を\(R\)に置き換えれば推定の信頼区間の式が得られる。
仮説検定
仮説検定
Point 2BC 8.8.1 仮説検定の手順
STEP1. 帰無仮説と対立仮説を立てる ・帰無仮説:確かめたいことを否定する内容 ・対立仮説:確かめたい内容 STEP2. 帰無仮説を前提として確率を計算し,棄却域を求める。
STEP3. 有意水準と確率を比較して判断する
確率 \(\leqq\) 有意水準 なら帰無仮説を棄却して対立仮説が残る
確率 \(>\)有意水準 なら帰無仮説は棄却されずにどちらも残る
確率 \(\leqq\) 有意水準 なら帰無仮説を棄却して対立仮説が残る
確率 \(>\)有意水準 なら帰無仮説は棄却されずにどちらも残る
Point 2BC 8.8.2 両側検定
帰無仮説のもとで,検定に用いる量\(T\)を標準化した値を
\[
Z=\dfrac{T-(\text{期待値})}{(\text{標準偏差})}
\]
とおく。有意水準5%の棄却域は,
\[
\class{mathkuu}{\underline{|Z|\geqq 1.96}}
\]
を満たす範囲とする(有意水準1%のときは\(|Z|\geqq 2.58\))。このように,棄却域を分布の両側に設定するような検定を両側検定という。

(i) 標本平均\(\overline{X}\)(母平均\(m\),母標準偏差\(\sigma\)):\(|\overline{X}-m|\geqq\class{mathkuu}{\underline{1.96\times\dfrac{\sigma}{\sqrt{n}}}}\)(\(\sigma\)は標本の標準偏差\(s\)でおき換えてもよい)
(ii) 成功回数\(X\)(成功確率\(p\)の反復試行):\(|X-np|\geqq\class{mathkuu}{\underline{1.96\times\sqrt{np(1-p)}}}\)
(iii) 標本比率\(\dfrac{X}{n}\):\(\left|\dfrac{X}{n}-p\right|\geqq\class{mathkuu}{\underline{1.96\times\sqrt{\dfrac{p(1-p)}{n}}}}\)((ii)の両辺を\(n\)で割ったもの)
※\(1.96\)などの値は,覚えていなくても正規分布表から求められる。表の値は\(P(0\leqq Z\leqq z)\)であり,棄却域の端の外側の確率を\(0.5\)から引いた値を表から探す。
| 有意水準 | 両側検定 | 片側検定 |
| 5% | \(0.5-0.025=0.4750\ \text{より}\ 1.96\) | \(0.5-0.05=0.4500\ \text{より}\ 1.64\) |
| 1% | \(0.5-0.005=0.4950\ \text{より}\ 2.58\) | \(0.5-0.01=0.4900\ \text{より}\ 2.33\) |
例題 ある工場の製品の不良品の割合は,従来\(10\%\)であるといわれていた。製品を\(900\)個調べたところ,不良品が\(111\)個あった。不良品の割合は従来と変わったといえるか。有意水準5%で検定せよ。
解 「変わったか」を調べるので両側検定を行う。帰無仮説を「不良品の割合は\(0.1\)である」とし,棄却域は\(|Z|\geqq 1.96\)とする。同じデータを,次の3通りの見方で検定できる。
(ii)の見方 不良品の個数\(X\)に着目する。帰無仮説のもとで\(X\)は二項分布\(B(900,\ 0.1)\)に従い \[ E(X)=900\times 0.1=90,\qquad \sqrt{V(X)}=\sqrt{900\times 0.1\times 0.9}=9 \] \(n\)が大きいので\(X\)は正規分布で近似できる。\(X=111\)のとき \[ Z=\dfrac{111-90}{9}=\class{mathkuu}{\underline{\dfrac{7}{3}}}=2.33\cdots \] (iii)の見方 不良品の標本比率\(R=\dfrac{X}{n}=\dfrac{111}{900}=\dfrac{37}{300}\)に着目する。帰無仮説のもとで \[ E(R)=0.1,\qquad \sqrt{V(R)}=\sqrt{\dfrac{0.1\times 0.9}{900}}=\dfrac{1}{100} \] であるから \[ Z=\dfrac{\dfrac{37}{300}-\dfrac{1}{10}}{\dfrac{1}{100}}=\dfrac{\dfrac{7}{300}}{\dfrac{1}{100}}=\dfrac{7}{3}=2.33\cdots \] (i)の見方 製品1個ごとに,不良品なら\(1\),そうでなければ\(0\)をとる変数を考える。母集団の平均は\(m=0.1\),標準偏差は\(\sigma=\sqrt{0.1\times 0.9}=0.3\)である。標本平均は\(\overline{X}=\dfrac{111}{900}=\dfrac{37}{300}\)(不良品の標本比率と一致する)で,\(n=900\)であるから \[ Z=\dfrac{\overline{X}-m}{\dfrac{\sigma}{\sqrt{n}}}=\dfrac{\dfrac{37}{300}-\dfrac{1}{10}}{\dfrac{0.3}{30}}=\dfrac{7}{3}=2.33\cdots \] どの見方でも\(Z=2.33\cdots\)となり,\(|Z|\geqq 1.96\)を満たす。よって帰無仮説は棄却され,不良品の割合は従来と変わったといえる。
解 「変わったか」を調べるので両側検定を行う。帰無仮説を「不良品の割合は\(0.1\)である」とし,棄却域は\(|Z|\geqq 1.96\)とする。同じデータを,次の3通りの見方で検定できる。
(ii)の見方 不良品の個数\(X\)に着目する。帰無仮説のもとで\(X\)は二項分布\(B(900,\ 0.1)\)に従い \[ E(X)=900\times 0.1=90,\qquad \sqrt{V(X)}=\sqrt{900\times 0.1\times 0.9}=9 \] \(n\)が大きいので\(X\)は正規分布で近似できる。\(X=111\)のとき \[ Z=\dfrac{111-90}{9}=\class{mathkuu}{\underline{\dfrac{7}{3}}}=2.33\cdots \] (iii)の見方 不良品の標本比率\(R=\dfrac{X}{n}=\dfrac{111}{900}=\dfrac{37}{300}\)に着目する。帰無仮説のもとで \[ E(R)=0.1,\qquad \sqrt{V(R)}=\sqrt{\dfrac{0.1\times 0.9}{900}}=\dfrac{1}{100} \] であるから \[ Z=\dfrac{\dfrac{37}{300}-\dfrac{1}{10}}{\dfrac{1}{100}}=\dfrac{\dfrac{7}{300}}{\dfrac{1}{100}}=\dfrac{7}{3}=2.33\cdots \] (i)の見方 製品1個ごとに,不良品なら\(1\),そうでなければ\(0\)をとる変数を考える。母集団の平均は\(m=0.1\),標準偏差は\(\sigma=\sqrt{0.1\times 0.9}=0.3\)である。標本平均は\(\overline{X}=\dfrac{111}{900}=\dfrac{37}{300}\)(不良品の標本比率と一致する)で,\(n=900\)であるから \[ Z=\dfrac{\overline{X}-m}{\dfrac{\sigma}{\sqrt{n}}}=\dfrac{\dfrac{37}{300}-\dfrac{1}{10}}{\dfrac{0.3}{30}}=\dfrac{7}{3}=2.33\cdots \] どの見方でも\(Z=2.33\cdots\)となり,\(|Z|\geqq 1.96\)を満たす。よって帰無仮説は棄却され,不良品の割合は従来と変わったといえる。
Point 2BC 8.8.3 片側検定
検定を行う際,棄却域を分布の片側に設定することもある。このような検定を片側検定という。標準化した値\(Z\)について,有意水準5%の棄却域は,上側に設定するときは
\[
\class{mathkuu}{\underline{Z\geqq 1.64}}
\]
下側に設定するときは\(Z\leqq -1.64\)とする(有意水準1%のときは\(2.33\)を用いる)。

※両側検定では有意水準5%の棄却域を両側2.5%,2.5%に分配するが,片側検定では、片側のみ5%で棄却域を取るので,同じ有意水準の場合は片側検定のほうが棄却されやすくなる。
※両側検定にするか片側検定にするかは実験の目的に合わせて検定を行う前に決めておくべきで,両側検定をやってみて帰無仮説が棄却されないからといって、当初の実験計画から外れて片側検定をやる、というのは誤り。例えば臨床試験に関する原則として片側検定なら2.5%,両側検定なら5%で行うように定められていたりすることもある。
※両側検定にするか片側検定にするかは実験の目的に合わせて検定を行う前に決めておくべきで,両側検定をやってみて帰無仮説が棄却されないからといって、当初の実験計画から外れて片側検定をやる、というのは誤り。例えば臨床試験に関する原則として片側検定なら2.5%,両側検定なら5%で行うように定められていたりすることもある。
例題 ある工場の製品の不良品の割合は,従来\(10\%\)であるといわれていた。製品を\(900\)個調べたところ,不良品が\(106\)個あった。有意水準5%で,次の問いに答えよ。
(1) 不良品の割合は従来と変わったといえるか。
(2) 不良品の割合は従来より増えたといえるか。
解 不良品の個数を\(X\)とすると,帰無仮説「不良品の割合は\(0.1\)である」のもとで\(X\)は\(B(900,\ 0.1)\)に従い,\(E(X)=90\),\(\sqrt{V(X)}=9\)である。標準化した値は\(Z=\dfrac{X-90}{9}\)で,\(X=106\)のとき\(Z=\dfrac{16}{9}\fallingdotseq 1.78\)である。
(1) 「変わったか」は両側検定であり,棄却域は\(|Z|\geqq 1.96\)。\(|Z|=1.78<1.96\)であるから棄却域に入らず,帰無仮説は棄却されない。よって,変わったとはいえない。
(2) 「増えたか」は片側検定(上側)であり,棄却域は\(Z\geqq 1.64\)。\(Z=1.78\geqq 1.64\)であるから棄却域に入り,帰無仮説は棄却される。よって,増えたといえる。
※同じデータでも,両側検定と片側検定で結論が分かれることがある。だからこそ,どちらを用いるかは検定の前に決めておく。
(1) 不良品の割合は従来と変わったといえるか。
(2) 不良品の割合は従来より増えたといえるか。
解 不良品の個数を\(X\)とすると,帰無仮説「不良品の割合は\(0.1\)である」のもとで\(X\)は\(B(900,\ 0.1)\)に従い,\(E(X)=90\),\(\sqrt{V(X)}=9\)である。標準化した値は\(Z=\dfrac{X-90}{9}\)で,\(X=106\)のとき\(Z=\dfrac{16}{9}\fallingdotseq 1.78\)である。
(1) 「変わったか」は両側検定であり,棄却域は\(|Z|\geqq 1.96\)。\(|Z|=1.78<1.96\)であるから棄却域に入らず,帰無仮説は棄却されない。よって,変わったとはいえない。
(2) 「増えたか」は片側検定(上側)であり,棄却域は\(Z\geqq 1.64\)。\(Z=1.78\geqq 1.64\)であるから棄却域に入り,帰無仮説は棄却される。よって,増えたといえる。
※同じデータでも,両側検定と片側検定で結論が分かれることがある。だからこそ,どちらを用いるかは検定の前に決めておく。
【コラム】この章の証明一覧
この章で公式として使ってきた式の証明をまとめておく。テストでは結果を使えれば足りることが多いので,読み物として,あるいは「なぜ独立が必要なのか」を確かめたいときに開いてみてほしい。どの証明も,定義の式に代入して整理するだけで進む。Point 2BC 8.9.1 【証明】分散の別表現 \(V(X)=E(X^2)-\{E(X)\}^2\)
\(E(X)=m\)とおく。\(X\)のとりうる値を\(x_1,\ x_2,\ \cdots,\ x_n\),対応する確率を\(p_1,\ p_2,\ \cdots,\ p_n\)とすると\(\sum p_k=1\),\(\sum x_kp_k=m\)であるから
\[
\begin{aligned}
V(X)&=\sum\limits_{k=1}^n (x_k-m)^2p_k\\
&=\sum x_k^2p_k-2m\sum x_kp_k+m^2\sum p_k\\
&=E(X^2)-2m\cdot m+m^2\cdot 1\\
&=E(X^2)-m^2
\end{aligned}
\]
Point 2BC 8.9.2 【証明】一次式の変換 \(E(aX+b),\ V(aX+b)\)
\[
E(aX+b)=\sum (ax_k+b)p_k=a\sum x_kp_k+b\sum p_k=aE(X)+b
\]
また,\(E(X)=m\)とすると\(E(aX+b)=am+b\)であるから
\[
\begin{aligned}
V(aX+b)&=\sum\{(ax_k+b)-(am+b)\}^2p_k\\
&=a^2\sum (x_k-m)^2p_k=a^2V(X)
\end{aligned}
\]
標準偏差は\(\sqrt{a^2V(X)}=|a|\sigma(X)\)となる。
\(Z=\dfrac{X-m}{\sigma}\)(標準化)のときは,\(E(Z)=\dfrac{m-m}{\sigma}=0\),\(V(Z)=\dfrac{1}{\sigma^2}\cdot\sigma^2=1\)となる。
Point 2BC 8.9.3 【証明】期待値の和 \(E(X+Y)=E(X)+E(Y)\)
\(X,\ Y\)の同時分布を\(P(X=x_i,\ Y=y_j)=p_{ij}\)とする。\(\sum\limits_j p_{ij}=P(X=x_i)\),\(\sum\limits_i p_{ij}=P(Y=y_j)\)であるから
\[
\begin{aligned}
E(X+Y)&=\sum\limits_{i,j}(x_i+y_j)p_{ij}\\
&=\sum\limits_i x_i\sum\limits_j p_{ij}+\sum\limits_j y_j\sum\limits_i p_{ij}\\
&=\sum\limits_i x_iP(X=x_i)+\sum\limits_j y_jP(Y=y_j)\\
&=E(X)+E(Y)
\end{aligned}
\]
途中で\(X,\ Y\)の独立は使っていないので,独立でなくても成り立つ。
Point 2BC 8.9.4 【証明】独立のときの \(E(XY)\) と \(V(X+Y)\)
(i) \(X,\ Y\)が独立のとき,\(p_{ij}=P(X=x_i)P(Y=y_j)\)であるから
\[
\begin{aligned}
E(XY)&=\sum\limits_{i,j}x_iy_jP(X=x_i)P(Y=y_j)\\
&=\Bigl\{\sum\limits_i x_iP(X=x_i)\Bigr\}\Bigl\{\sum\limits_j y_jP(Y=y_j)\Bigr\}=E(X)E(Y)
\end{aligned}
\]
(ii) 一般に,\(V(X)=E(X^2)-\{E(X)\}^2\)を用いると
\[
\begin{aligned}
V(X+Y)&=E\bigl((X+Y)^2\bigr)-\{E(X)+E(Y)\}^2\\
&=\bigl[E(X^2)-\{E(X)\}^2\bigr]+\bigl[E(Y^2)-\{E(Y)\}^2\bigr]\\
&\qquad+2\bigl\{E(XY)-E(X)E(Y)\bigr\}\\
&=V(X)+V(Y)+2\bigl\{E(XY)-E(X)E(Y)\bigr\}
\end{aligned}
\]
\(X,\ Y\)が独立なら(i)より最後の項が\(0\)になり,\(V(X+Y)=V(X)+V(Y)\)が成り立つ。
最後の項\(E(XY)-E(X)E(Y)\)は,数学Ⅰの共分散(\(xy\)の平均\(-\)\(x\)の平均\(\times\)\(y\)の平均)と同じ形である。独立でないときに分散の和が分けられないのは,この共分散が\(0\)とは限らないからと読める。
Point 2BC 8.9.5 【証明】二項分布の期待値・分散
\(X\sim B(n,\ p)\)とし,\(q=1-p\)とおく。\(i\)回目の試行が成功なら\(1\),失敗なら\(0\)をとる確率変数を\(X_i\)とすると
\[
X=X_1+X_2+\cdots+X_n
\]
各\(X_i\)について
\[
E(X_i)=1\cdot p+0\cdot q=p,\qquad V(X_i)=E(X_i^2)-p^2=p-p^2=pq
\]
\(X_1,\ \cdots,\ X_n\)は互いに独立であるから
\[
E(X)=np,\qquad V(X)=npq,\qquad \sigma(X)=\sqrt{npq}
\]
Point 2BC 8.9.6 【証明】標本平均の期待値・分散
母平均\(m\),母標準偏差\(\sigma\)の母集団から大きさ\(n\)の無作為標本\(X_1,\ \cdots,\ X_n\)を(復元)抽出するとき,各\(X_i\)は母集団と同じ分布に従い\(E(X_i)=m,\ V(X_i)=\sigma^2\)で,互いに独立である。\(\overline{X}=\dfrac{1}{n}(X_1+\cdots+X_n)\)であるから
\[
E(\overline{X})=\dfrac{1}{n}\cdot nm=m
\]
\[
V(\overline{X})=\dfrac{1}{n^2}\cdot n\sigma^2=\dfrac{\sigma^2}{n},\qquad \sigma(\overline{X})=\dfrac{\sigma}{\sqrt{n}}
\]
母比率\(p\)の母集団なら,各\(X_i\)は\(1\)か\(0\)の変数で\(m=p,\ \sigma^2=pq\)であるから,標本比率\(R=\overline{X}\)について\(E(R)=p,\ V(R)=\dfrac{pq}{n}\)となる。
Point 2BC 8.9.7 【証明】二項分布の期待値・分散(二項定理を使う別証明)
\(X\sim B(n,\ p)\),\(q=1-p\)とする。\(P(X=k)={}_n\mathrm{C}_k\,p^kq^{n-k}\)であり,二項定理より,\(x\)についての恒等式
\[
(x+q)^n=\sum\limits_{k=0}^{n}{}_n\mathrm{C}_k\,x^kq^{n-k}
\]
が成り立つ。両辺を\(x\)で微分すると
\[
n(x+q)^{n-1}=\sum\limits_{k=1}^{n}k\,{}_n\mathrm{C}_k\,x^{k-1}q^{n-k}
\]
両辺に\(x\)を掛けて\(x=p\)とし,\(p+q=1\)を用いると
\[
E(X)=\sum\limits_{k=0}^{n}k\,{}_n\mathrm{C}_k\,p^kq^{n-k}=np(p+q)^{n-1}=\class{mathkuu}{\underline{np}}
\]
もう一度微分すると
\[
n(n-1)(x+q)^{n-2}=\sum\limits_{k=2}^{n}k(k-1)\,{}_n\mathrm{C}_k\,x^{k-2}q^{n-k}
\]
であり,同様に\(x^2\)を掛けて\(x=p\)とすると
\[
E(X(X-1))=n(n-1)p^2
\]
よって
\[
V(X)=E(X(X-1))+E(X)-\{E(X)\}^2=n(n-1)p^2+np-n^2p^2=np(1-p)=\class{mathkuu}{\underline{npq}}
\]
微分を使わない方法もある。\({}_n\mathrm{C}_k\cdot k=n\,{}_{n-1}\mathrm{C}_{k-1}\)(\(n\)人から\(k\)人の委員を選んでその中の委員長を決める方法を,2通りに数えた式)を用いると,\(E(X)=\sum k\,{}_n\mathrm{C}_k\,p^kq^{n-k}=np\sum {}_{n-1}\mathrm{C}_{k-1}\,p^{k-1}q^{n-k}=np(p+q)^{n-1}=np\)。
Point 2BC 8.9.8 【証明】チェビシェフの不等式と大数の法則
高校の教科書の範囲外だが,「標本が大きいほど標本平均が母平均に近づく」ことの理由になっているので,流れだけ確認しておく。
確率変数\(X\)の平均を\(m\),分散を\(V(X)\),\(c>0\)とする。分散の定義の和のうち,\(|x_k-m|\geqq c\)の項だけを取り出して考えると \[ V(X)=\sum (x_k-m)^2p_k\geqq\sum\limits_{|x_k-m|\geqq c}(x_k-m)^2p_k\geqq c^2\sum\limits_{|x_k-m|\geqq c}p_k=c^2\,P(|X-m|\geqq c) \] よって \[ P(|X-m|\geqq c)\leqq\dfrac{V(X)}{c^2}\qquad\text{(チェビシェフの不等式)} \] 標本平均\(\overline{X}\)に適用すると,\(E(\overline{X})=m,\ V(\overline{X})=\dfrac{\sigma^2}{n}\)(Point8.9.6)なので,どんな小さい\(c>0\)についても \[ P(|\overline{X}-m|\geqq c)\leqq\dfrac{\sigma^2}{nc^2}\longrightarrow 0\quad(n\to\infty) \] 標本の大きさ\(n\)を大きくすると,標本平均が母平均から\(c\)以上ずれる確率はいくらでも小さくなる。これが大数の法則である。
確率変数\(X\)の平均を\(m\),分散を\(V(X)\),\(c>0\)とする。分散の定義の和のうち,\(|x_k-m|\geqq c\)の項だけを取り出して考えると \[ V(X)=\sum (x_k-m)^2p_k\geqq\sum\limits_{|x_k-m|\geqq c}(x_k-m)^2p_k\geqq c^2\sum\limits_{|x_k-m|\geqq c}p_k=c^2\,P(|X-m|\geqq c) \] よって \[ P(|X-m|\geqq c)\leqq\dfrac{V(X)}{c^2}\qquad\text{(チェビシェフの不等式)} \] 標本平均\(\overline{X}\)に適用すると,\(E(\overline{X})=m,\ V(\overline{X})=\dfrac{\sigma^2}{n}\)(Point8.9.6)なので,どんな小さい\(c>0\)についても \[ P(|\overline{X}-m|\geqq c)\leqq\dfrac{\sigma^2}{nc^2}\longrightarrow 0\quad(n\to\infty) \] 標本の大きさ\(n\)を大きくすると,標本平均が母平均から\(c\)以上ずれる確率はいくらでも小さくなる。これが大数の法則である。
Point 2BC 8.9.9 【リンク】その他の証明
この章の振り返り
いかがでしたでしょうか。確率分布と統計は,公式そのものよりいま何の分布の話をしているのかを見失うことで難しくなる章でした。だから最初に全体像を置き,\(3\)つのテーマに分けています。前半の確率分布は,実質数学Ⅰのデータの分析の焼き直しでした。期待値を平均と読みかえれば,分散も標準偏差も変量の変換も,見覚えのある式に戻ります。「\(2\)乗の平均\(-\)平均の\(2\)乗」も,\(x\)を\(ax+b\)に置きかえたとき分散が\(a^2\)倍・標準偏差が\(|a|\)倍になることも,まったく同じです。新しく覚えることはほとんどない,と気づけたかどうかが最初の分かれ目でした。
独立の扱いは,この章でつまずきやすいところです。「事象の独立」「試行の独立」「確率変数の独立」と名前が\(3\)つ出てきますが,中身はどれも確率が掛け算になることでした。カルノー図で区切りがそろうかどうかを見る方法は,計算せずに独立かどうかを判断できるので,一度手を動かして確かめておくと感覚が残ります。そして「\(X,\ Y\)が独立」と書かれていたら,期待値の積と分散の和が分解できる合図——ここまで反射にできれば,前半の目的は達成です。期待値の和だけは独立でなくても分解できる,という非対称も押さえておいてください。
二項分布からは,どんなときにその分布を持ち出すかという判断が中心になります。毎回の確率が変わらない反復試行で,結果が\(2\)状態のものを数える。サイコロ・コイン・良品と不良品・当たりくじ。この道具立てが見えたら二項分布を疑い,試行回数\(n\)と成功確率\(p\)の\(2\)つを押さえる。期待値\(np\)は「毎回の確率を\(n\)回ぶん」と読めば覚える必要すらありません。
正規分布のところは,計算よりなぜ標準化するのかが要でした。世の中には平均も標準偏差も違う正規分布が無数にあり,そのすべてについて確率の表を用意することはできません。だから山の位置を\(0\)に,形を\(1\)にそろえて,\(1\)枚の表で済ませる。\(Z=\dfrac{X-m}{\sigma}\)の\(m\)を引くのが位置合わせ,\(\sigma\)で割るのが形合わせでした。直線や放物線を「位置」と「形」で捉えたのと同じ発想です。そのうえで表から確率を読むときは,\(0.5\)・くり抜き・折り返しの\(3\)つで攻める。表に載っているのは「\(0\)から\(z\)まで」だけなので,欲しい面積をその足し引きで作るという一手だけです。
後半の統計的な推測は,全部を調べられないから一部で代用するという話でした。その代用が許される根拠が中心極限定理です。もとの分布がどんな形でも,標本平均は正規分布に近づく。だから母集団の正体を知らないまま,正規分布の道具一式を使って議論できる。推定も検定も,例外なくこの一点に乗っています。
推定では,信頼度\(95\%\)という言葉の意味を取り違えないでください。\(95\%\)の確率で母平均がその区間にあるのではなく,同じことを\(100\)回やれば\(95\)回くらいは区間が母平均を含むという意味です。母平均は動かない値で,抽出のたびに動くのは区間のほうでした。\(1.96\)という数字も,\(2\sigma\)で約\(95.45\%\)だから\(2\)より少し小さい,と納得しておけば忘れません。
検定は手順が決まっています。確かめたいことを否定する帰無仮説を立て,それを前提に確率を計算し,有意水準と比べる。ここで注意したいのは,棄却されなかったことは「正しいと証明された」ことではないという点です。あくまで「否定できなかった」だけで,どちらも残ります。片側にするか両側にするかを検定前に決めておくべきなのも同じ理由で,結果を見てから都合よく選ぶのは,有意水準をこっそり緩めることに等しくなります。
データの分析(数学Ⅰ)とのつながりも意識しておいてください。あちらは手元にあるデータそのものを要約する話で,この章は手元にないものを確率で語る話です。平均・分散・標準偏差という道具は共通ですが,扱う対象が「全部見えているデータ」から「一部しか見えない母集団」に変わっている。この違いが分かると,同じ記号が出てくるのに考え方が違う理由が見えてきます。 また,この分野は共通テストで大問として出ることが多く,誘導に乗る力が問われます。一つひとつのPointは短くても,問題では「二項分布と見抜く→期待値と分散を出す→正規分布で近似する→標準化する→表を読む」と数珠つなぎで聞かれます。個々の公式を覚えるだけでなく,どの順に何をするかという流れごと頭に入れておくと,長い誘導でも迷子になりません。 この章は,公式の数だけ見ると多く感じます。けれど実際にやっていることは,分布の形を\(2\)つの数(平均と標準偏差)で捉え,標準化して\(1\)枚の表に帰着させ,標本から母集団を語るという一本の流れです。手が止まったときは,いま扱っているのが母集団の分布なのか標本平均の分布なのかを確かめてみてください。たいていの混乱はそこから始まっています。